时间序列调研
时序背景介绍
概念定义
什么是“时间序列”?
—— 简单说就是按时间顺序排列的数据,比如每天的气温、每小时的电力消耗、股票的实时价格。
时间序列数据分类
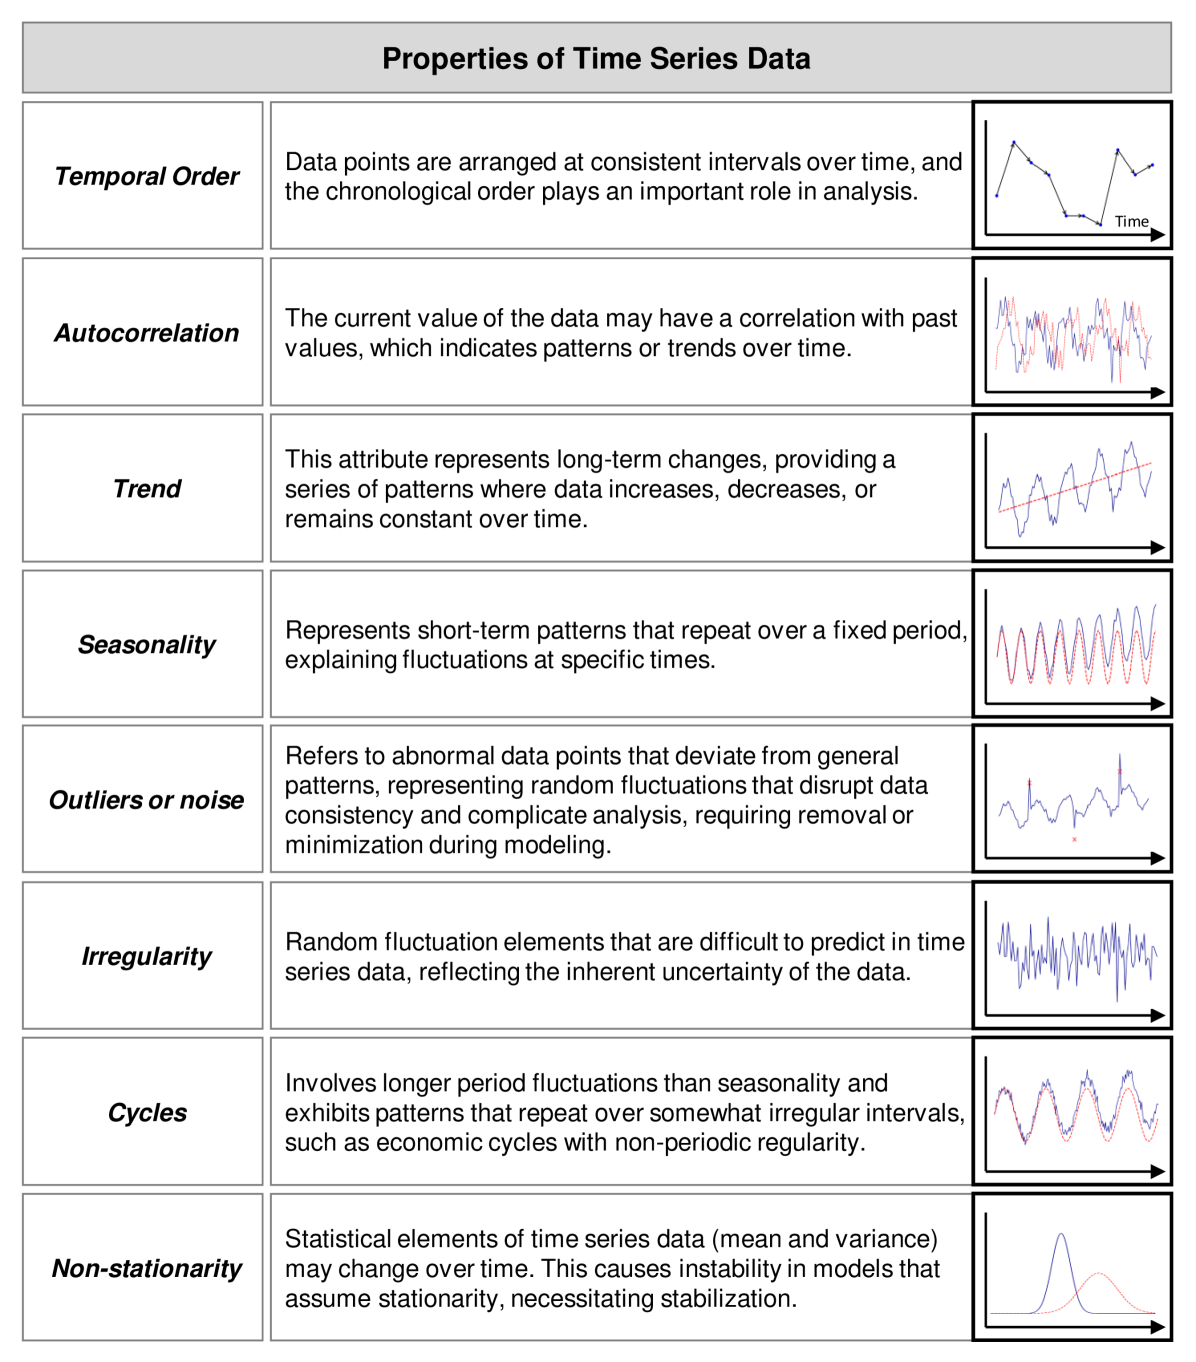
- 数据特性
时序数据本身具有以下特性:顺序性、自相关性、趋势、季节性、周期性、异常值、不规则采样、不平稳性
- 多维特性
多变量的时间序列数据还具有以下特性:变量间依赖性、受外源潜在变量影响、上下文信息等多源因素的影响。

时间序列任务分类
分类
根据整个序列的模式将其归入某一类别,在故障诊断、行为识别等领域中用到。

主要挑战在于:序列通常仅由少量数值点构成单次观测,单个时刻信息有限,需要考虑时序动态模式进行判别;不同类别序列的对齐与变长问题。
早期方法:依赖距离度量➕模版匹配;特征提取➕传统分类器。问题:对复杂模式难以分类,泛化性不强。
机器学习方法:SVM、频域分析改进分类效果。问题:在捕获长时依赖和非线性动态方面存在局限。
深度学习方法:CNN局部特征✅但长期依赖❌、RNN(LSTM)存在梯度消失/爆炸、Transformer需求数据量多,相对模型计算效率不高。
异常检测
旨在在时间序列中发现不符合正常模式的异常行为或异常点,在工业设备监测、网络安全、医疗监护等领域非常重要。==本质上和分类任务类似(二分类)==。

主要难点在于:异常样本稀少且多样,缺乏充足的有标签异常数据来监督模型训练;异常通常嵌藏在大量正常数据中,高罕见概率导致监督学习偏斜;同时异常定义依赖场景且会随时间演化(概念漂移),给模型带来持续适应挑战。
传统方法:基于统计阈值和信号处理(频谱分析)
机器学习方法:One-Class SVM、无监督聚类方法
深度学习方法:基于预测的异常检测方法,本质上还是对比误差(阈值)
预测
根据过去序列数据预测未来值,在金融、供应链、气象等领域有重要作用。时间序列预测需要应对趋势和季节性模式、多步预测误差累积、多变量关联等核心挑战。

经典统计方法:以统计模型为主,ARIMA结合自回归和滑动平均。解释性强且需要数据量少,但仅在简单数据上有效。
机器学习方法:回归模型中,过去观测为特征,未来值为标签。
深度学习方法:seq2seq多步预测→序列学习。Transformer改进版本Informer等,在特定数据集上面临过拟合和数据依赖。
生成建模
要求学得时间序列数据的分布,从而可以生成类似于真实的数据序列。这在模拟场景、数据扩增、隐私数据合成等方面有应用,例如生成真实风格的合成语音、模拟股票走势数据等。==本质上和预测任务类似。==

主要挑战在于:时间序列通常存在复杂的短期相关和长期结构,生成模型必须捕捉这种多尺度依赖;生成的不确定性很高,可能存在多峰分布(例如未来可能有多种走向),模型需表达多模态输出;此外,评估生成序列质量往往困难,没有明确的客观指标,比图像生成的视觉保真度更难衡量。
时序问题的痛点总结

数据层面共性问题
采样不规则、缺失与对齐:在现实中,由于采样过程不准确,数据往往存在间隔不等、变量异步、单位测量变化、缺失值等诸多问题,这将严重影响数据建模的分布情况,若预处理不当,脏数据将严重影响模型性能。
举例:在医疗健康领域,由于存在多源异步采样(生命体征、实验室检查、用药)、大量缺失且“信息性缺失”(测不到/不测往往本身有含义)、噪声与测量误差并存,随病程出现明显非平稳。
分布漂移(Distribution Shift):时间序列数据的非平稳性导致分布随时间发生变化,这是最具挑战性的痛点之一。现实世界并非静态的,事物在变化,数据分布会漂移。包括协变量漂移:输入特征分布发生变化;先验概率漂移:目标变量分布变化;概念漂移:输入与输出间关系发生变化。
举例:在工业传感器维护过程中,传感器数量多、工况切换频繁(负载、转速、环境),跨机型/批次的域间差异显著;寿命数据呈”运行到失效”的长尾形态。
尺度依赖与长序列建模:现实中的时间序列往往呈现出长时间跨度,其中既包含快速变化的局部模式(如突发事件、短周期波动),也蕴含缓慢演化的全局趋势(如病程进展、设备老化、市场长期走势)。
举例:在金融交易场景中,股票价格序列可能跨越数年,包含日内高频波动(毫秒/分钟级)与宏观经济周期(季度/年度级);在交通预测中,需要同时建模局部的高峰拥堵模式与长期的出行结构变化。
多变量关联与外生驱动:多变量之间的时滞相关、共因与混杂使“相关≠因果”。变量间复杂依赖和外部因素影响构成了多变量时序建模的核心难题。
举例:电力价格高度依赖于市场供需关系,仅基于历史数据预测未来价格在本质上是不可能的,需要纳入经济指标、政策变化等外生变量(金融市场交易更是如此)。
标注稀缺、异常稀少、异常定义主观:实际应用中,异常点极少且定义依赖场景,标注代价高,很多公开基准集的标签与分布也难覆盖真实复杂性,直接迁移会导致评测与落地的“指标—价值错位”。
任务相关的特定痛点
| 任务类型 | 核心挑战 | 常用解决方案 |
|---|---|---|
| 分类 | ① 动态模式主导、单点判别力弱 ② 变长与相位错位导致比对困难 ③ 小样本/跨域泛化差 |
传统方法:1NN+DTW动态对齐、手工特征+SVM 深度学习:CNN提取局部模式、原型学习增强泛化 预处理技巧:序列对齐、patch分块化 |
| 预测 | ① 趋势/季节与短期扰动并存 ② 多步误差累积 ③ 长序列计算负担 ④ 多变量/外生驱动与分布漂移 |
经典统计:ARIMA/ETS分解+线性回归 深度学习:LSTM记忆门控、Transformer自注意力 新兴方法:线性模型(LTSF-Linear)、扩散模型 应对策略:模型集成、滚动再训练、patch化处理 |
| 异常检测 | ① 极端不平衡与多样形态,标签稀缺 ② 概念/工况演化致阈值失稳 ③ 评测需兼顾早检出与误报成本 |
无监督方法:Isolation Forest、One-Class SVM 深度学习:预测残差分析、自编码器重构误差 自适应技术:动态阈值调整、概念漂移监测 |
| 生成建模 | ① 多峰/多模态未来、不确定性高 ② 长程一致性与物理/业务约束 ③ 质量评估缺乏统一指标 |
传统生成:HMM隐马尔可夫、状态空间模型 深度生成:TimeGAN对抗训练、VAE变分自编码器 扩散模型:TimeGrad概率预测、CSDI条件生成 |
时序方法发展脉络
时序方案发展趋势:
- 从手工到自动:特征工程→端到端学习
- 从单一到混合:单模型→集成/多尺度/分解式组合
- 从确定到概率:点预测→分布/不确定性建模
- 从固定到自适应:静态模型→在线学习/概念漂移适应
大模型前的发展
时间线:从20世纪后期的统计模型(ARIMA、HMM等),到21世纪初的机器学习方法(SVM、随机森林等),再到近十年的深度学习模型(RNN/LSTM、CNN、Transformer等),方法不断演进以应对数据规模和复杂性的增长。


传统统计 & 机器学习
最早的时序预测以指数平滑、ARIMA/SARIMA为代表,依赖平稳性与线性自回归/滑动平均假设;随后出现树模型、SVM等机器学习范式以刻画部分非线性关系,但整体仍难以充分捕捉复杂长期依赖与多变量交互。
传统深度学习
- RNN/LSTM强化记忆门控以减轻梯度问题、增强长依赖;
- TCN/CNN用空洞卷积与大感受野高效建模长序列;
- GNN在图结构下学习跨通道关系。
这些架构能学到更复杂的时序模式,但也受各自”归纳偏置”所限(如RNN顺序递归瓶颈、CNN局部性)。
Transformer & Advanced Transformer
自注意力善于处理==序列长程依赖==(时序数据中的长序列和LLM中的长上下文的“长”不在同一个量级),迅速扩展到时序预测并取得强势表现;
围绕自注意力的可扩展性与时序归纳偏置进行增强:
Patching 提升长序列效率;提升长距离预测能力。
Cross-dimension 显式建模多通道相关性;提升多尺度能力。
Exogenous(外生条件/先验)与Additional Approaches(如稀疏注意力等)进一步贴合多变量、异质分布的数据特性。


在“注意力可扩展性 + 时序归纳偏置”上做强化:通过稀疏化/频域变换/多尺度结构/内置分解来降低复杂度、显式注入周期与趋势先验,并配合直接多步解码以提升长序列预测稳定性。

Autoformer:把趋势–季节分解内置到网络中,跨层迭代“去趋势/还原趋势”;以Auto-Correlation替代点对点注意力,直接在周期/子序列层面建模长期依赖。Encoder: 每次分解都会把趋势-循环成分剥离,保留更“纯”的季节表示; Decoder: 并行地把每次分解得到的趋势分量经投影器加入“趋势累积”

FEDformer:在频域/小波域进行子带选择与交互(Frequency-Enhanced Block/Attention),再逆变换回时域;与序列分解结合,突出低频趋势与主要周期,近线性代价生成长跨度预测。
==和大模型不同的是,这些Transformer还是端到端、确定数据集训练的小模型。==
问题:研究发现简单线性/分解式模型在若干基准上可与甚至超越Transformer,引发对”何为时序有效归纳偏置”的再思考。
“归纳偏置” inductive bias。它指的是学习算法/模型先验地带入的一套假设与约束——决定了模型更容易学习哪类模式、忽略哪类模式,从而影响在有限数据上的泛化。
在时序建模里,可以把“归纳偏置”理解为:模型对时间顺序、平稳性、局部性/周期性、跨变量关系等特性的内置假设与结构设计,如:RNN/LSTM:结构上按时间顺序递推,隐状态携带历史,这天然把“时间有序连续”作为偏置;门控机制则偏向保留长期关键信息。CNN/TCN:卷积的局部性与多尺度使其偏向捕捉邻域模式、周期/季节性等局部规律,常与强调全局关系的模型形成互补。简单线性/分解式模型(LTSF-Linear 等):偏向趋势+季节性成分的直接提取与严格的时间顺序保真,在一些长序列任务上胜过复杂注意力模型。
“线性可赢“ linear wins。在长时序预测(LTSF)等任务上,极其简单的线性模型(例如对分解后的序列做线性映射)在若干基准上打败了不少基于 Transformer 的复杂模型,引发了社区对“什么才是时序合适的归纳偏置”的反思。
Advanced Traditional DL
在”线性可赢”的启发下,对MLP/CNN/RNN/GNN进行**轻量化、混合式与模型无关(model-agnostic)**改造,重点在于==利用时序本身特征,提高建模效率==:
混合方法(Hybrid):将线性趋势/季节分解与深度特征提取结合;典型思路是先做时间序列分解(趋势、季节/周期、残差),然后各自建模再重组;也有把小波/频域分解出来的分量交给CNN/GNN/MLP/Transformer分头处理再融合的做法。

LTSF-Linear/DLinear/NLinear:通过最简单的线性加权、加上趋势/季节分解或归一化,就能在不少基准任务上接近甚至超越复杂的 Transformer。
DLinear: 趋势–季节分解 + 两个 Linear。
NLinear:简单归一化 + Linear + 还原操作。
我之前参与的关于ESN的研究本质上就是利用周期性结合RNN来优化时序特征提取过程。
更高效的CNN/TCN或门控RNN:用于长期依赖与局部模式的折中;以卷积提取局部/多尺度模式,时间与显存开销都低于自注意力,且与时序的周期/季节性很匹配;常与全局方法互补。
Inception Time - CNN变体:多尺度+残差增强。
Inception block详细如下:Bottleneck:对每个时间步做 1×1 卷积(即仅沿通道维线性变换,不在时间上卷积),把通道从 $M$ 压缩到 $m$,图中m取1。随后接不同长度 $l\in{10,20,40}$ 的 1D 卷积核(都沿时间维),再加一个 MaxPooling 分支。四个分支的输出在通道维拼接,形成该 Inception 模块的输出。

经典的TimesNet将时序数据2维化后进行卷积

图神经网络(GNN):显式表达通道图结构,能把多变量时序的通道相关性建成图,同时学习时空关系。
“模型无关”不是指”不要模型”,而是指改进策略与技巧不绑定某一类主干。”特征提取/分解/频域变换”等做法,不局限于特定架构,可跨多种模型复用。
Diffusion Models
扩散模型通过“正向加噪→反向去噪”的两步生成,前向过程把真实未来片段逐步加上高斯噪声;反向过程从随机噪声出发,借助一个去噪网络一步步去噪得到未来序列。
DDPM 的核心是学一个“估计噪声$\hat\epsilon_\theta(x_t,t,c)$ ”的单步去噪器 ,然后在采样时把上一步的噪声减掉、按噪声日程一步步“从噪声走回数据”。

做预测时采用条件生成:用历史序列作为条件,让反向去噪朝着与历史一致的未来演化。
条件只喂给去噪网络,而前向噪声本身仍是固定的高斯加噪过程。时序预测通常只对”未来窗口”加噪、历史只作为条件输入。
Diffusion在时序(主要是预测)中从”条件怎么喂“(编码、未来先验)与”特征怎么抽“(分解/频域/多尺度)两端同时演进,目标是把历史先验+结构特征+去噪网络三者对齐,从而既保留趋势/周期,又能刻画不确定性。
==采用Diffusion视角的TS是一个概率分布问题,而DL/Transformer系方法是回归式建模。Diffusion有更强的生成能力,适合 多模态、不确定性显著的预测。==
Mamba Models
SSM 离散状态空间模型:把序列建模问题转化为一个线性系统的卷积问题。相比于Transformer、RNN系列模型,SSM具有”长依赖+高效率”的特性。

SSM把序列建模还原为一个线性时不变(LTI)系统的卷积核问题,离散定义为:
$$
x_t=Ax_{t-1}+Bu_t,\qquad y_t=Cx_t+Du_t
$$
其中 $A$ 决定了记忆的“保留时间”。逐步展开后,得到:
$$
y_t = \sum_{k \ge 0} K_k, u_{t-k} + D u_t, \quad K_k = C A^k B
$$
也就是说,输出 $y_t$ 并不是只依赖于最近的输入,而是依赖于所有过去的输入,只不过”远处的记忆”会随着 $A^k$ 衰减(不同于马尔可夫性,如RNN模型)。长记忆:矩阵 $A$ 的特征值控制衰减速度。
- 如果 $|\lambda| < 1$,那么 $A^k$ 对应的项会以 $\lambda^k$ 形式衰减。
- 如果 $|\lambda|$ 很接近 1(实部接近 0),衰减就很慢,意味着能记住很久。
- 如果有一组不同大小的特征值分布,就相当于组合了短期记忆(快速衰减)和长期记忆(慢速衰减),形成多时间尺度记忆机制。
高效率:
输出公式:$y_t = \sum_{k \ge 0} K_k, u_{t-k}$ 其实就是卷积 $y = K * u$
- 在 RNN 里,须一步一步传递信息:从 $t-1$ 推到 $t$,时间复杂度是 $O(T)$
- 在 Transformer 里,虽然是全局注意力,但计算复杂度是 $O(T^2)$,因为要比较所有 pairwise 的依赖。
- 在 SSM 里,卷积可以用 FFT 或者扫描算法来实现,复杂度是接近 $O(T \log T)$ 或甚至 $O(T)$,而且可以一次性并行计算全序列,而不需要逐步传递。
LTI假设:系统是线性且参数不随时间变。
SSM的优势来自:
- 数学最优性(HiPPO):正交多项式基提供最优历史压缩
- 谱优化:特征值分布实现多尺度记忆
- 计算效率(S4):NPLR+Cauchy实现近线性复杂度
- 并行性:LTI特性允许全局卷积
Mamba:提出”选择性SSM“,由于纯LTI-SSM对输入自适应性不够、在信息稠密的离散领域(如文本)偏弱。让SSM参数随输入动态变化以选择性记忆/遗忘,从而使得Mamba具有更灵活、无注意力、高吞吐的序列主干;其变体围绕稳定性、通道依赖、与Transformer技巧融合持续演化,并在多篇工作中报告优于Transformer基线。

让 $\Delta_t,B_t,C_t$ 依输入而变,得到内容依赖的动态滤波器:遇到”无关token”就把 $\Delta_t$ 变大以”重置/忽略”,遇到关键信息则让状态持续。
==从传统方法到现代方法的发展脉络清晰:更强的非线性学习能力、更长的依赖记忆能力、更少的人工干预特征,以及更好的不确定性刻画。==
大模型-时序分析
LLM-TS 背景
“Can large pretrained models trained on massive amounts of time-series data learn temporal patterns that can be useful for time-series forecasting on previously unseen datasets?”
Motivation
- 更强的泛化性(zero-shot):预训练时间序列“基础模型”在跨领域、跨频率、跨变量的零样本预测上显示出可迁移性。
- 更高的数据效率(few-shot):参数高效微调将通用LLM对齐到时间序列后,少量标注即可优于专用模型性能。
- 利用LLM的链式推理与prompt:通过重编程与”Prompt-as-Prefix”等机制,用自然语言上下文强化时间序列的推理与解释,从语言模型的理解角度检验其对”纯数值预测”是否真正有效。
- 多模态融合:将数值序列与文本元数据/事件描述等共同建模,有助于场景知识注入与可解释性。
Challenge
时序—语言的模态对齐难题:连续、噪声敏感、非平稳的时间序列与离散、语义稠密的自然语言存在表征偏差;现有对齐路径包括(i)重编程/前缀提示(Time-LLM),(ii)量化/标记化为“时间序列词表”(Chronos),(iii)指令/两阶段对齐(LLM4TS,TimeCMA),但一致而稳健的跨任务对齐仍未解决。
“离散词元 vs. 连续数据”的信息权衡:量化/标记化便于复用LLM架构与采样式概率预测,但可能带来数据精度与分布细节的损失。
知识与推理范式差异:LLM的语言归纳偏置未必天然迁移到数值动态建模;”序列建模”能力对纯时序任务的提升有限,优势更可能体现在多模态/工具增强场景。本质还是对齐问题没有解决。
数据与基准的短板:对于时序数据而言,高覆盖、多域、多频率的预训练语料与统一评测基准仍稀缺。
两种建模范式
LLM时序离散化/重编程:把时序数据与语言模态对齐
TIME-LLM (ICLR 2024)
利用已有的大语言模型骨干网络,通过重编程层实现时序-文本模态对齐。
Time-LLM保持大语言模型主干冻结,通过”reprogramming”把连续时序重编码为文本原型(text prototypes),再配合**Prompt-as-Prefix (PaP)**引导LLM对时序patch的表征与转换,最后经投影层回到数值空间做预测。

Patch Reprogramming:把每个patch的向量表示投影到LLM的词向量空间里,用**一小组从词表嵌入中筛选出来的”文本原型”**作为”基底”去重构(加权组合)这些patch,使两种模态在表示空间上对齐。
这些text prototypes可学习到诸如”short up / steady down”等语言线索,并以组合方式表示局部时序模式(如”先短上升再平稳下降”),相当于用少量语义化”基向量”去编码patch语义。


Prompt-as-Prefix:把文本提示作为前缀与经重编程后的patch表达一起输入冻结的LLM;前向后丢弃前缀部分,仅用输出表征做线性投影得到预测值,如上图所示。
提示由三部分组成:dataset context、task instruction、input statistics**(趋势、滞后等)**,示例如下图所示:

实验结果:用TIME-LLM预测电力、天气、交通等数据,TIME-LLM在长/少样本与跨域预测上整体领先,零样本跨域(用A领域数据训练,直接预测没见过的B领域数据)相较次优基线比传统专用预测模型效果更好。
TimeCMA (AAAI 2025)
TimeCMA面向多变量时间序列预测(MTSF),采用”两支路编码+模态对齐+预测解码”的架构:

双模态编码:
时间序列编码(TSE):用一个轻量的Transformer Encoder编码历史数值,得到每个变量/通道各自的向量表示(它的好处是”按变量分得开”)。
LLM Prompt编码:把同一段数值写成Prompt,送进冻结的GPT-2,只取最后一个token的向量作为该变量的提示表示,并且把这个最后token离线缓存,训练/推理时复用。
模态对齐(CMA):
此处并没有直接将双模态编码后的结果拼起来,而是基于Channel设计了相似度检索,即TSE当”检索器”Q,LLM Prompt编码当”资料库”K V,按相似度对V做聚合,再叠加到原始数值特征上,得到对齐后的数据token向量(类似一种交叉注意力的设计)。
通道级相似度检索(channel-wise similarity retrieval)
令
- $H_T\in\mathbb{R}^{C\times N}$:TSE 输出(按变量组织);
- $L_N\in\mathbb{R}^{N\times E}$:每变量的 LLM 最后 token 表征。
首先用三组线性映射把两模态投影到对齐空间:
$$
Q=\psi_q(H_T),\quad K=\psi_k(L_N),\quad V=\psi_v(L_N).
$$
计算通道-嵌入二维的相似度矩阵并归一化:
$$
M_T=\mathrm{softmax}\big(Q;\otimes;K\big)\in\mathbb{R}^{C\times E}.
$$
用该相似度对 $V$ 做聚合并与原时序加入性融合,得到对齐后的表征:
$$
H_C=\omega_c\big(V;\otimes;M_T\big);\oplus;H_T.
$$
预测头:
将对齐后的 $H_C$ 输入多变量Transformer解码器(含自注意与跨注意)以建模变量间长期依赖,最后经线性投影得到未来 $M$ 步的多变量预测并做反归一化。
实验表明,相比Time-LLM的直接拼接,TimeCMA的对齐方式效果更好。
原生时序基础模型:直接读懂时间序列
Chronos(TMLR 2024)
Chronos把实值序列通过mean scaling+等距量化变成有限词表上的token序列,用标准T5或GPT2做next token prediction;推断时自回归地产生未来tokens并映回实数,多次采样即可得到概率型预测。

数值序列经缩放(scaling)与量化(quantization)后,被离散到 $B$ 个bins,每个bin对应一个离散token id,即自然数集合 ${1,\dots,B}$。此外还会加入PAD与EOS两个特殊符号,构成时间序列词表 $V_{\text{ts}}$。
论文将量化范围设为 $[-15,+15]$,在区间 $r \in [-15, 15]$ 内创建4096个等间距的Bin,$q(x) = \arg\min_j |c_j - x|$,其中$c_j$为第j个Bin的中心。
模型在每个步长预测下一个token的分布 $p_\theta(z_{C+h+1}\mid z_{1:C+h})$,对真实量化标签做多类交叉熵训练:
$$
\ell(\theta)=-\sum_{h=1}^{H+1}\sum_{i\in V_{\text{ts}}}\mathbf{1}(z_{C+h+1}=i)\log p_\theta(i\mid z_{1:C+h}) .
$$
在推断过程中,将每个预测token $z$ 映射到中心 $d(z)=c_z$,再乘以尺度 $s$(mean scaling的逆变换)得到实值预测。
Chronos不具备通用的自然语言理解/生成能力。
TimesFM(ACM 2024)
目标:旨在学习一个统一的零样本预测器 $f:(y_{1:L})\to \hat y_{L+1:L+H}$,在未知的目标数据集上直接以不同历史长度 $L$、不同预测步长 $H$、以及不同时间粒度(分钟/小时/日/周/月等)工作。
架构:
输入端做patch化,每个补丁经一个带跳连的单隐层MLP变换到model_dim维度后,加上位置编码作为Transformer的输入token。
decoder-only Transformer:模型由标准Transformer构成(多头自注意力+前馈网络),使用causal mask:第 $j$ 个输出只能注意到自身及其之前的token。
输出patch长度 $h$ 可以大于输入补丁长度 $p$($h>p$)。每个输出token通过一个输出残差块直接预测后续 $h$ 个时间步。在output_patch上取input_patch作为下一轮自回归的输入,便于交叉核对。
在约100B时间点规模(实数据+合成)上预训练,模型规模约200M参数。在多个新数据集的零样本预测中,精度接近针对单数据集全监督训练的专用模型。

Time-MoE (ICLR 2025)
TimeMoE以decoder-only Transformer+稀疏MoE为骨干,采用逐点嵌入、RMSNorm、RoPE、Top-k路由+共享专家实现高容量与低算力并存;在目标端采用多分辨率自回归与贪心调度支持任意预测长度;基于Time-300B的大规模预训练,配合Huber损失+负载均衡辅助损失与统一的数据工程/采样策略,实现了在相同激活算力下优于同规模稠密模型的时序基础模型。


实验效果优于TimesFM、Chronos、Moiral等一众原生大模型。
Agent视角
用LLM+Agent策略理解时序,进行时序分析。本质上,预测、分类等时序分析问题都是为了在场景下根据分析到的结果做出决策。AI Agent若能将时序分析工具嵌入其中,将赋能金融交易、工业检测等重要活动。
“a planner agent equipped with structured knowledge banks, curated libraries of models and refinement strategies, which guide exploration, while improving interpretability and reducing error propagation.”
Agent通过结构化知识库、精选模型库和细化策略,可指导相关领域探索,同时提高可解释性并减少错误传播。
TS-Agent
Structured Agentic Workflows for Financial Time-Series Modeling with LLMs and Reflective Feedback 2025.8
一个面向金融时间序列的模块化智能体框架,通过结构化的推理与反思式反馈自动化完成建模流程。其总体思想是把工作流形式化为包含模型选择→代码细化→超参微调的迭代决策过程,并以结构化知识库(案例库、代码库、细化/诊断知识库)为外部”支撑”来约束与引导搜索,从而兼顾性能、可审计性与鲁棒性。

总体两阶段:
- Stage 1:模型预选 —— 用案例库做相似任务检索,给出top-k候选模型并在
train.py中具体化; - Stage 2:代码细化 —— 采用”两阶段轮转搜索(Warm-up/Optimization)”,围绕最优候选持续迭代”细化+微调”,若指标提升则保留,否则回退。
需要训练学习的是任务模型的参数,即train.py的训练,不需要学习agent模型,agent只做检索、编辑、执行与决策编排。

TS-Agent规划能力的背后,本质上还是要有核心的time series analysis的分析模型、案例和规划数据。如在金融场景下的:
①”Case Bank案例库“:沉淀过往金融时序任务与成功策略,例如基于案例推理(CBR)做候选模型预选与启发式约束;
②”Financial TS Code Base代码库“:现成的、能直接用的金融模型代码和评估工具(预测:DLinear/TimesNet/Autoformer/PatchTST/TimeMixer;生成:GAN/VAE/扩散等);
③”Refinement Knowledge Bank优化知识库“:金融领域专业操作技巧,模型的训练优化策略(比如怎么处理数据、怎么调参数能减少误差)。
在加密货币、外汇与美股等任务上,TS-Agent相较AutoML与通用Agent基线取得更优的预测精度、风控一致性与成功率。
FLAIRR-TS
FLAIRR-TS – Forecasting LLM-Agents with Iterative Refinement and Retrieval for Time Series 2025.8
目标:在无需微调的前提下,通过检索的可解释外部证据与在线提示改写协同,动态适配不同数据与领域的模式,而非为每个任务手工调参。

FLAIRR-TS将时间序列预测(TSF)表述为一个多智能体、测试时优化的问题:由Forecaster生成初始预测;Retriever从历史库检索与当前片段最相似的”类比样本”补充上下文;Refiner作为”元优化器”根据过往提示词→误差轨迹,迭代改写提示词并触发早停;整个循环在不更新权重的前提下完成(仅通过提示词优化)。
- Forecaster生成初始预测,由”当前提示词+检索增强上下文(C_aug)”驱动生成预测。预测目标变量在未来 $H$ 步的数值序列;输出格式被强制规范为:
Predicted Values: [v1, v2, …](数值数组),并附带Reasoning、Certainty Estimate与Certainty Reasoning三个解释与置信度字段。 - Retriever依据皮尔逊相关系数从训练划分按滑窗构建的历史库中取Top-M与当前上下文最相似的历史片段,并连同它们的真实后续走势一起提供,作为”类比演化示例“,用以直接增强Forecaster的输入上下文 $C_{aug}$。
- Refiner作为”元优化器”根据过往提示词→误差轨迹,迭代改写提示词并触发早停;整个循环在不更新权重的前提下完成(仅通过提示词优化)。
过往科研工作总结
Reservoir Computing 基础
模型空间学习 (Model Space Learning)
1. 为什么要”从数据空间转到模型空间”
真实时序常见问题:噪声大、采样不齐、序列长短不一、训练样本少、环境在变。直接在”数据空间”做端到端学习,往往既要解决长依赖与缺失,又要抵抗噪声与域移,训练代价高、可解释性弱。连续时间工作在摘要里把核心痛点概括得很准:不规则采样、样本稀缺、环境变化下的故障诊断;常见插值/重采样会扭曲原始变化信息,而连续时间网络直接训练又计算开销大。
MSL的动机就是绕开这些”数据层面的坑”,把”序列→能生成它的一个小模型”,再在”模型的参数/函数“上做判别或检索。
2. MSL的定义与总体目标
定义:先为每条序列拟合一个能刻画其动态生成机制的”小模型”(如ESN/ODE-ESN/AR/状态空间等),用**”拟合好的模型本身”**当作该序列的表示。
目标:得到抗噪声、对采样机制/长度不敏感、可解释、少样本也稳定的时序表征,并显著降低训练代价(比如只训练读出层或在模型参数上做轻量分类)。
3. MSL的流程
- 模型化表征阶段(拟合模型阶段):对每条序列,选择一个小而”对口”的生成模型并单独拟合。
- 构建模型度量:直接用参数向量(如拼接后的Wout)做欧氏/马氏距离;或把模型看成函数 $F(\cdot,\Theta)$,以 $|F(\cdot,\Theta_1)-F(\cdot,\Theta_2)|$ 这类函数距离比较。
- 判别式学习阶段:在”模型特征/模型度量”上训练一个轻量分类器或度量学习器即可(弱化了端到端大网络的训练压力)。

ESN高效模型拟合
回声状态网络(Echo State Network, ESN)是一类简化的离散时间递归神经网络(RNN),主要用于处理具有上下文依赖的序列数据。与传统RNN不同,ESN中输入权重 $W^{hx}$ 和储备池(reservoir)权重 $W^{hh}$ 在初始化时随机生成并在训练过程中保持固定,仅输出权重 $W^{yh}$ 通过训练获得。
架构

输入层:包含 $K$ 个单元,输入向量表示为
$$
x(n) = \big(x_1(n), x_2(n), \ldots, x_K(n)\big)^{\top} ,
$$
隐藏层(储备池):包含 $N$ 个非线性神经元,其状态为
$$
h(n) = \big(h_1(n), h_2(n), \ldots, h_N(n)\big)^{\top} ,
$$
在迭代过程中由当前输入和前一时刻的状态共同决定:
$$
h(n) = g!\big(W^{hh}h(n-1) + W^{hx}x(n)\big) ,
$$
其中 $g(\cdot)$ 通常为 $\tanh$。
为了保证网络稳定性,储备池必须满足回声状态性质(Echo State Property, ESP),即历史信息对当前状态的影响会随时间衰减。实践中常通过调整谱半径来实现:
$$
W^{hh} \leftarrow \frac{\alpha W^{hh}}{\lVert \lambda_{\max}\rVert}, \quad 0<\alpha<1 ,
$$其中 $\lVert \lambda_{\max}\rVert$ 是 $W^{hh}$ 的谱半径。
输出层:包含 $L$ 个单元,输出表示为
$$
y(n) = \big(y_1(n), y_2(n), \ldots, y_L(n)\big)^{\top} ,
$$
拟合方法-岭回归
在训练过程中,首先将输入序列逐步送入储备池,得到对应的隐藏状态集合 $H$。然后利用岭回归计算输出权重:
$$
W^{yh} = \big(H^{\top}H + \lambda^2 I\big)^{-1}H^{\top}Y ,
$$
其中 $Y$ 是目标输出,$\lambda > 0$ 为正则化参数。
综上,ESN能够高效地将带有上下文的时序数据映射到模型空间,并在一定程度上避免了传统RNN的梯度消失问题。
科研工作总结
1. 融合视觉与动态特征的时序数据异常检测
- 问题:2D/3D GPR中空间结构+回波动态信息耦合不足,易漏检/误检。
- 方法:采用视觉目标检测模型,通过提取视觉特征,进行异常区域空间定位。结合水平方向和垂直方向局部动态特征拟合多方向储备池网络,对拟合模型进行分类。

2. 基于频谱感知储备池计算网络的时序数据分类
- 问题:传统RC对多尺度频谱与周期/序列双通道动力学利用不足。
- 方法:先HP滤波去趋势→小波→FFT选”显著频率”→以频率为周期构造循环滞后状态(顺序Ws+周期Wc)、读出层岭回归,拼接多频动态特征做TSC;BiESN实现最优(算法/结论在文中)。
- 实验:在128个UCR/UEA数据集上实现快而准的分类。

3. 基于连续时间伴随学习的不规则序列故障诊断
- 问题:不规则采样/连续动力学下,离散RNN/ESN训练与梯度传播不稳定。
- 方法:把ESN推广为连续时间动态方程,用伴随法做稳定高效的神经微分方程优化。